Gemini 4 Argon và Gemini 3.8 Flash: đắt gấp 2,7 lần mà lại rẻ hơn? Thử thật 3 việc văn phòng
Cùng ba đề văn phòng gửi qua Gemini API, code chấm đúng sai: Flash đúng 15/15, Argon 14/15 nhưng rẻ hơn và nhanh hơn, dù giá mỗi token cao gấp 2,7 lần. Giá chính thức, cách thử và giới hạn của lần thử.
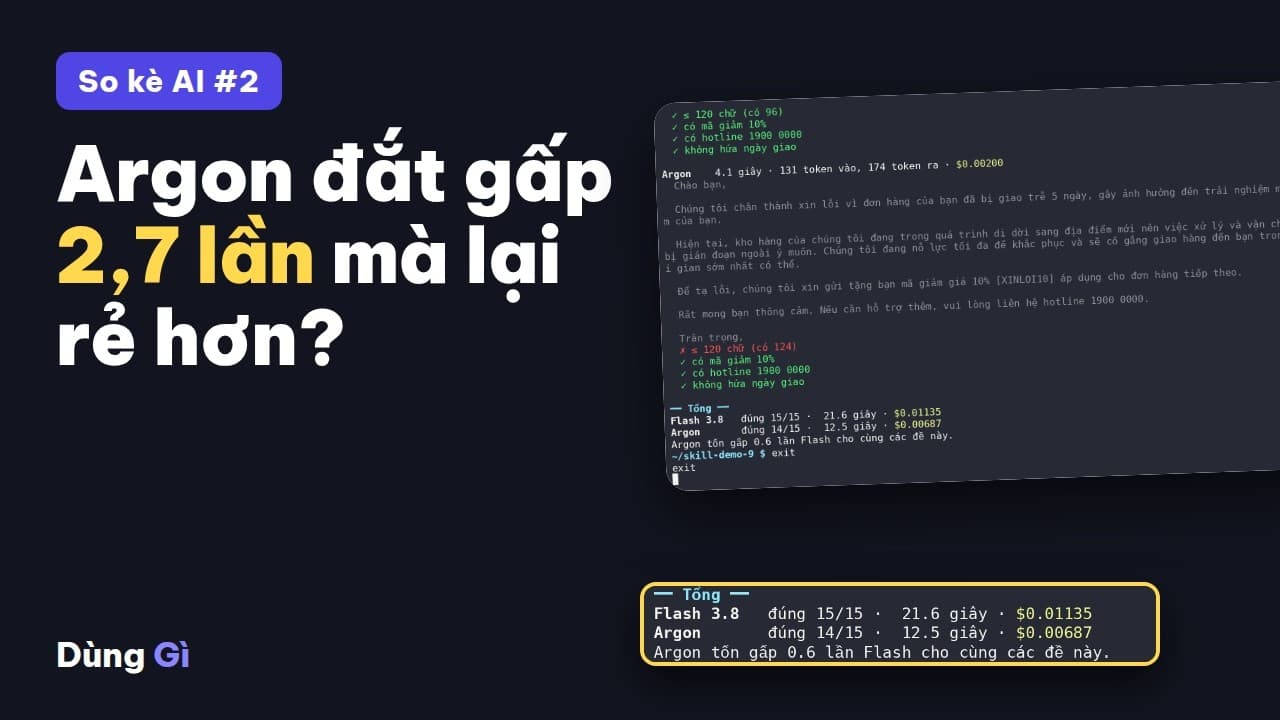
Gemini 4 Argon, model mạnh nhất Google vừa mở trên API, đắt gấp 2,7 lần Gemini 3.8 Flash cho mỗi token theo bảng giá. Vậy với việc văn phòng hằng ngày, trả nhiều hơn có được gì? Bài này cho cả hai làm cùng ba đề bài của So kè AI #1 qua Gemini API, chấm đúng sai bằng code với đáp án tính sẵn, rồi đo thời gian và tiền thật. Kết quả ngược với bảng giá: Argon rẻ hơn và nhanh hơn, nhưng trượt một mục.
Thử nghiệm ngày 14/10/2026, gọi Gemini API trực tiếp với
gemini-3.8-flashvàgemini-4-argon, để mức suy nghĩ mặc định của từng model. Mỗi đề chạy một lần, nên đây là quan sát thực tế, không phải thống kê. Đề bài là dữ liệu giả định. Giá lấy từ trang giá chính thức của Gemini API (cập nhật 13/10/2026, gói trả phí).
Xem video chạy thử thật: https://youtu.be/ygVlHxkqv7g
Hai model, giá mỗi token chênh 2,7 lần
| Gemini 3.8 Flash | Gemini 4 Argon | |
|---|---|---|
| Giá đầu vào (mỗi triệu token) | $0,75 (tới 31/12/2026), từ 1/1/2027 là $1,50 | $2 (giá giới thiệu tới 30/11/2026), từ 1/12/2026 là $4 |
| Giá đầu ra, tính cả token suy nghĩ (mỗi triệu token) | $3,75 (tới 31/12/2026), từ 1/1/2027 là $7,50 | $10 (tới 30/11/2026), từ 1/12/2026 là $20 |
| Gói miễn phí | Có | Không |
| Google mô tả | Model Flash thông minh nhất, cho lập trình dài hơi, agent tự hành, quy trình doanh nghiệp phức tạp | Model suy luận chủ lực, cửa sổ ngữ cảnh 1 triệu token |
Cả hai đều ở nhóm "Stable" trên trang model của Gemini API. Theo bảng giá, Argon không có ở gói miễn phí lẫn gói Google AI Pro. Nguồn: bảng giá Gemini API, trang model. Muốn biết Argon là gì, đọc Gemini 4 Argon là gì.
Cách thử
- Ba việc văn phòng, giống hệt So kè AI #1, đáp án tính tay trước khi chạy:
- Đọc một email lộn xộn để lấy thông tin xuất hoá đơn, trả về JSON. Bẫy: số tiền gõ nhầm đã đính chính, tên công ty cũ, hạn thanh toán viết bằng chữ.
- Tính hoa hồng bậc thang cho 5 nhân viên: 2% / 4% / 6% theo bậc, thưởng 1 triệu nếu doanh số từ 150 triệu và không có đơn hoàn. Bẫy: Dũng đúng 200 triệu, Hạnh 149,5 triệu (thiếu 500 nghìn là đủ thưởng), Chi đủ doanh số nhưng có đơn hoàn.
- Viết email trả lời khách bị giao trễ: tối đa 120 chữ, có mã giảm 10%, không hứa ngày giao, kết thúc bằng hotline.
- Cùng câu lệnh, gửi qua Gemini API cho từng model, để mức suy nghĩ mặc định.
- Code chấm từng mục: 5 trường của hoá đơn, 6 con số của bảng hoa hồng, 4 điều kiện của email. Tổng 15 mục mỗi model.
- Đo thật: thời gian từ lúc gửi tới lúc nhận, số token API báo về (đầu ra gồm cả token suy nghĩ), tiền tính theo bảng giá.
Kết quả từng đề
Đề 1: trích thông tin hoá đơn
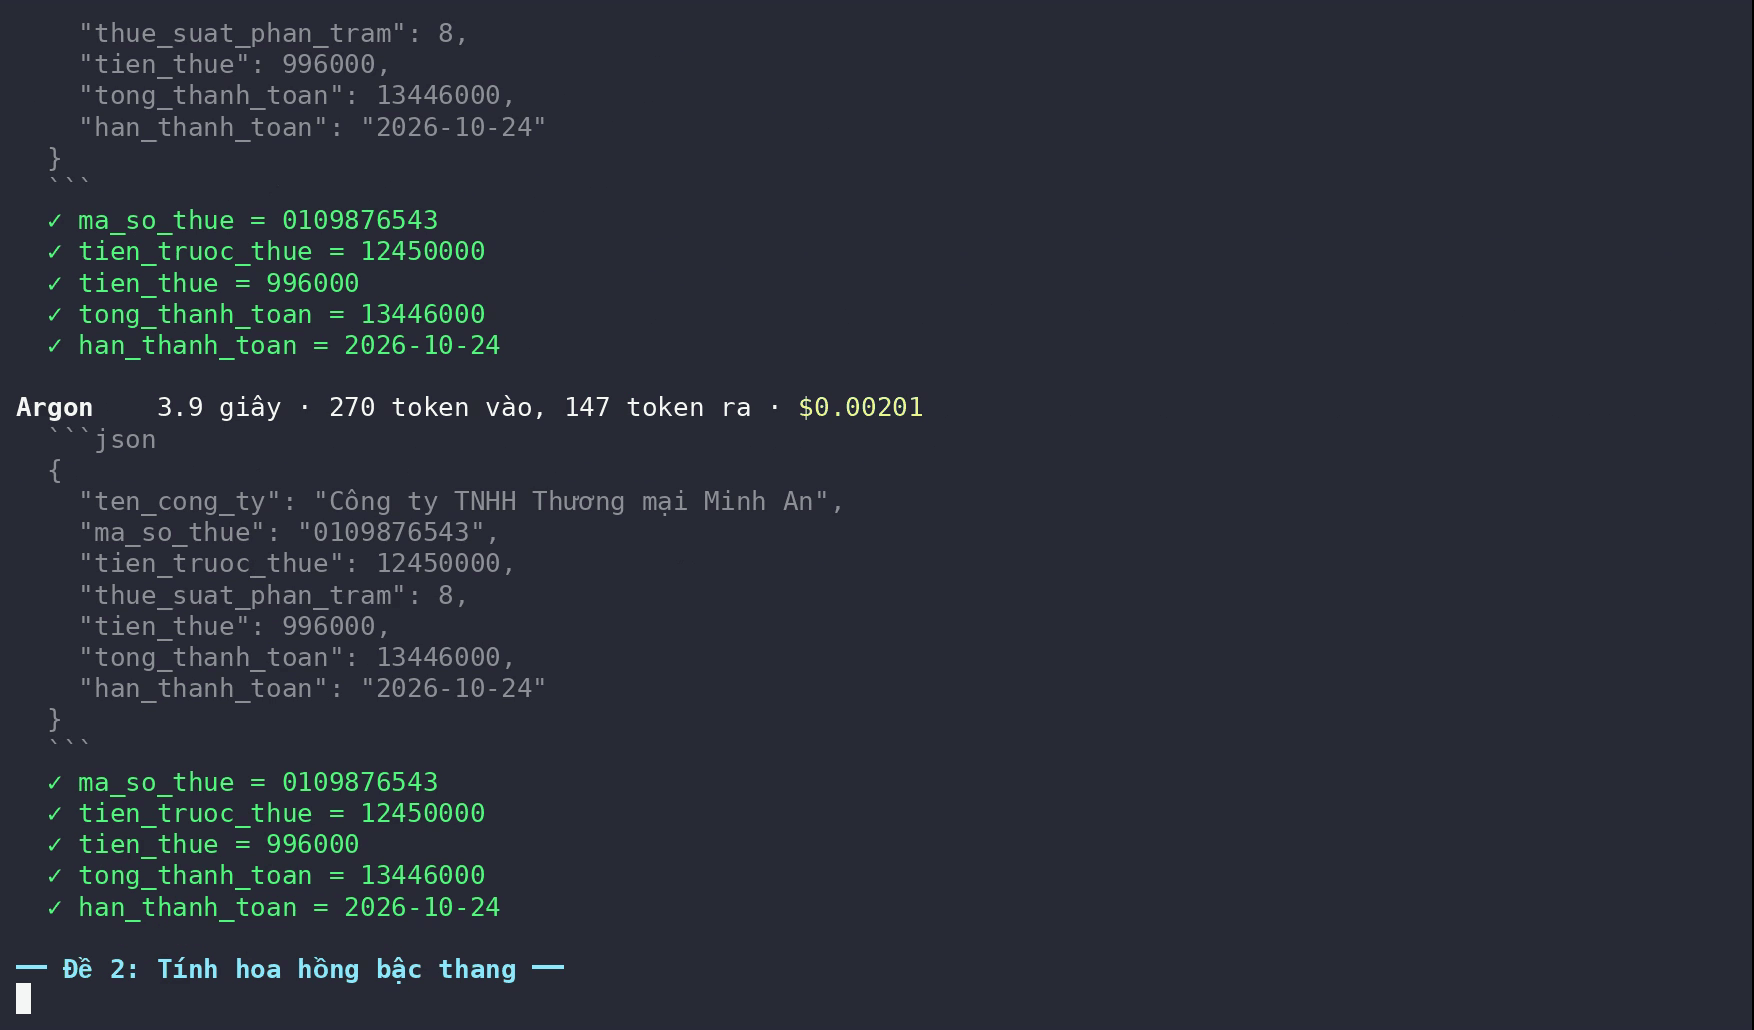
Cả hai trả về cùng một JSON, đúng cả 5 trường: mã số thuế, tiền trước thuế 12.450.000đ (không lấy số gõ nhầm), tiền thuế 996.000đ, tổng 13.446.000đ, hạn 24/10/2026. Thời gian gần như nhau: Flash 4,2 giây, Argon 3,9 giây. Khác ở token đầu ra: Flash dùng 490, Argon 147, dù câu trả lời giống hệt.
Đề 2: hoa hồng bậc thang
Cả hai tính đúng 6 con số, không trao thưởng nhầm cho Hạnh, và cùng làm đúng yêu cầu "Không giải thích": chỉ đưa bảng. Nhưng Flash mất 8,1 giây với 1.322 token đầu ra, còn Argon 4,6 giây với 234 token.
Đề 3: email trả lời khách
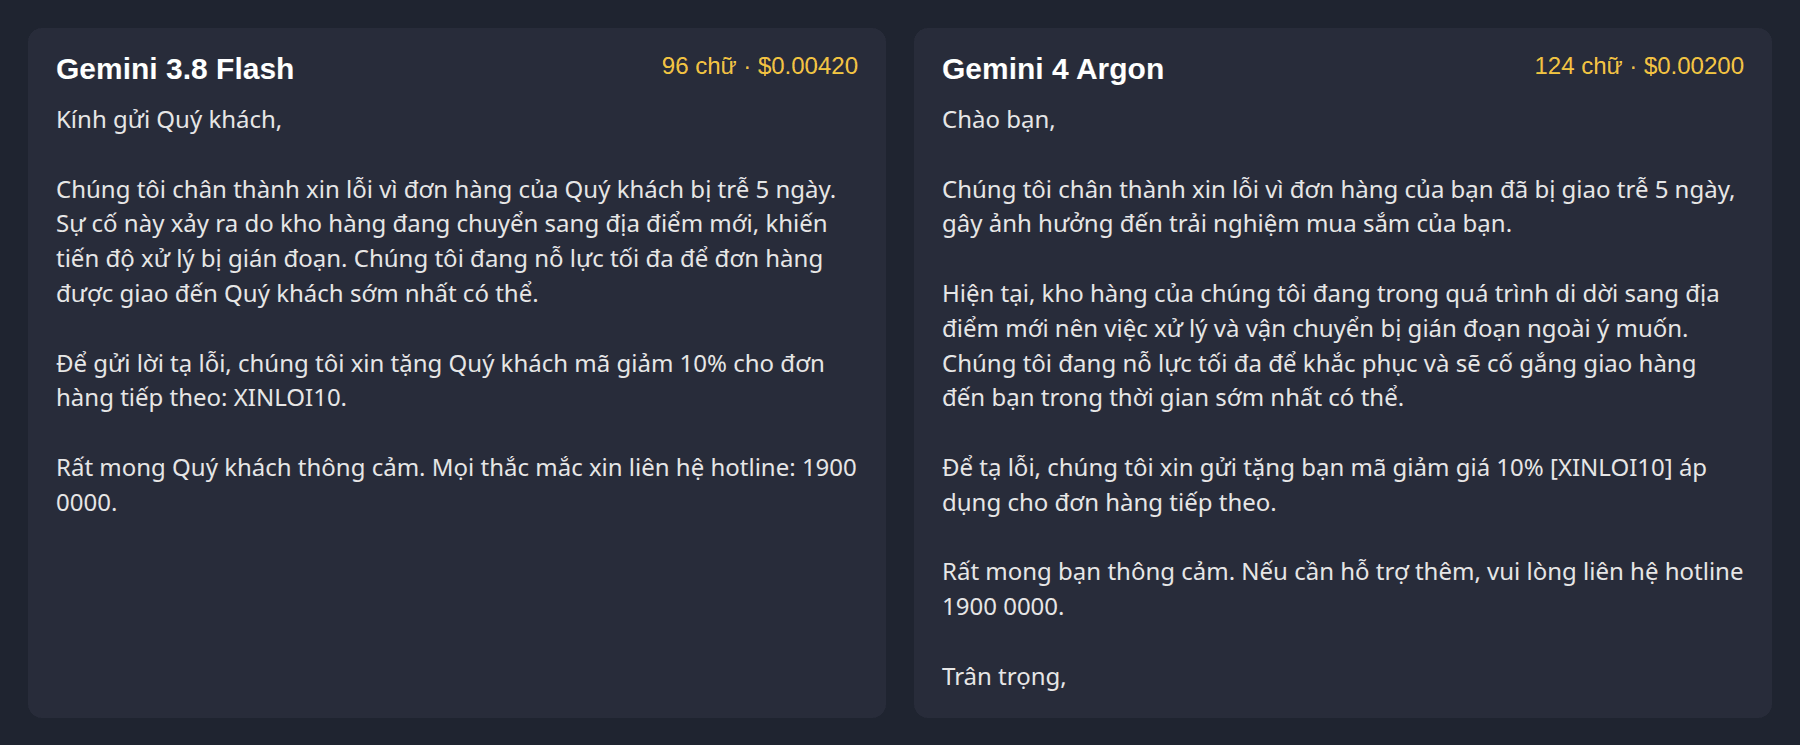
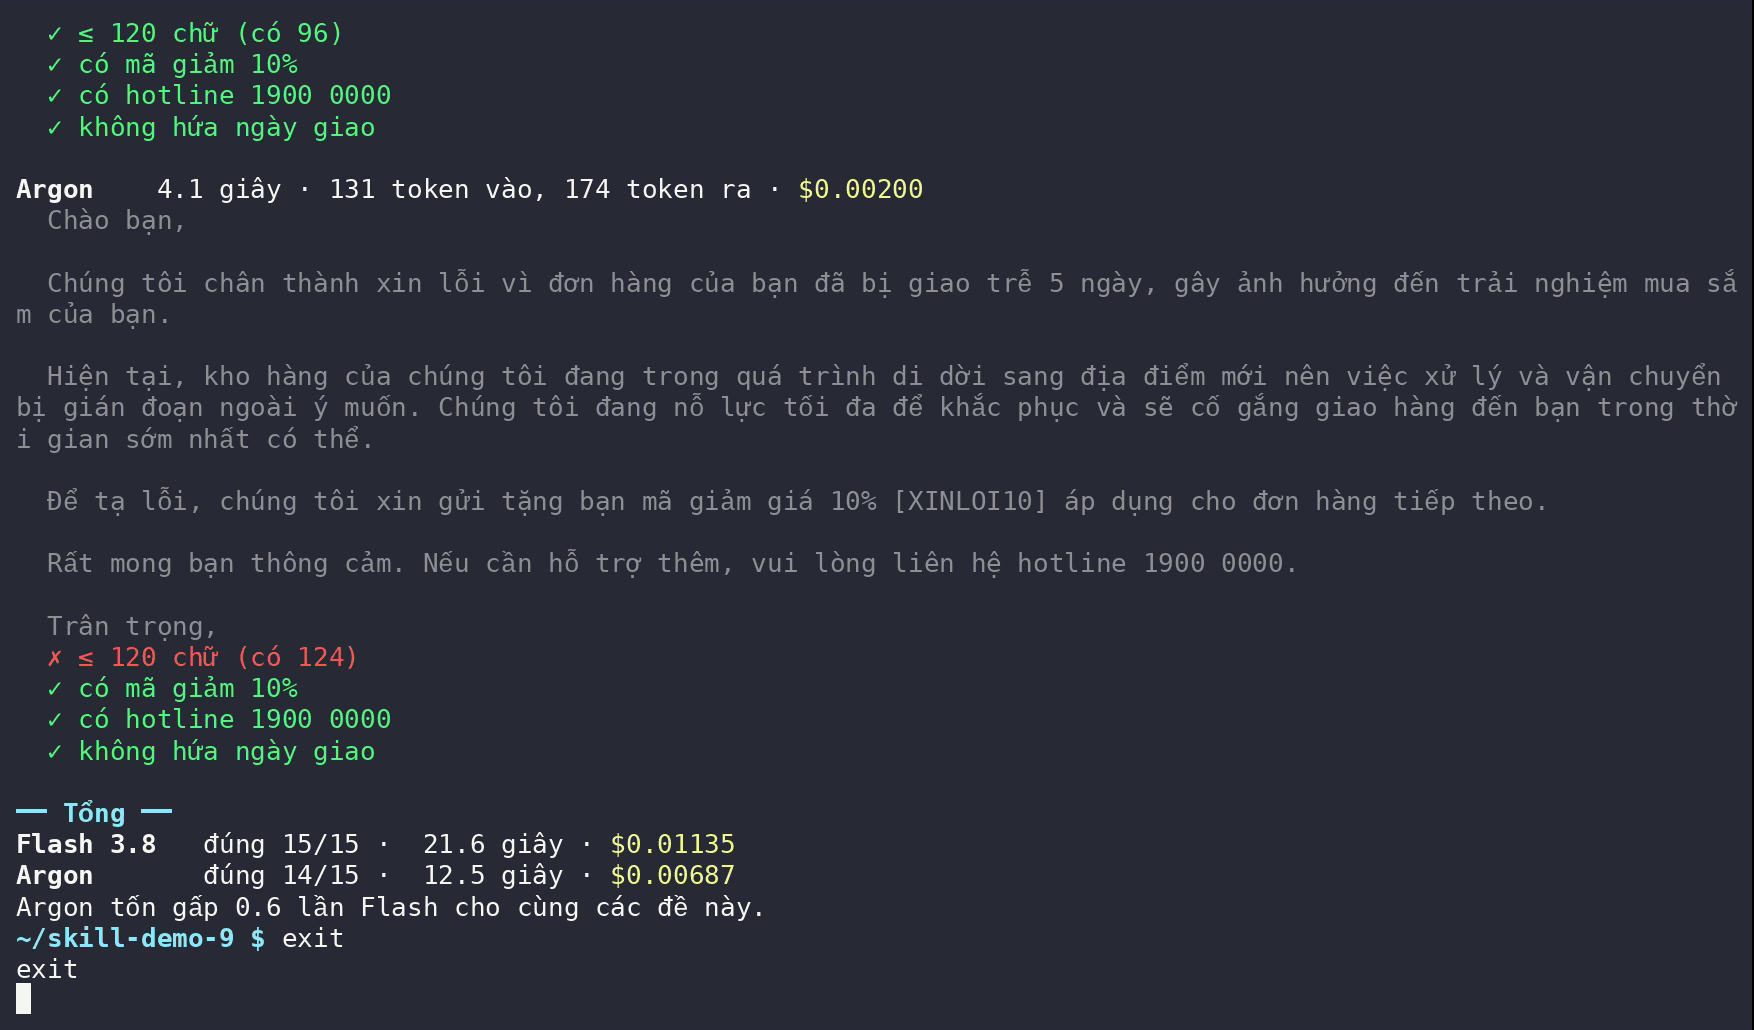
Đây là đề duy nhất có khác biệt về kết quả. Flash viết 96 chữ, qua cả 4 mục. Argon viết 124 chữ, vượt giới hạn 120 chữ, và còn để "Trân trọng," sau dòng hotline trong khi đề yêu cầu kết thúc bằng hotline (code chỉ kiểm có hotline, không kiểm vị trí). Cả hai đều có mã giảm 10%, không hứa ngày giao.
Tổng kết: Argon rẻ hơn, nhanh hơn, nhưng trượt một mục
| Gemini 3.8 Flash | Gemini 4 Argon | |
|---|---|---|
| Đúng (code chấm) | 15/15 | 14/15 |
| Tổng thời gian 3 đề | 21,6 giây | 12,5 giây |
| Tổng token đầu ra 3 đề (gồm suy nghĩ) | 2.912 | 555 |
| Tổng tiền 3 đề | $0,01135 | $0,00687 |
| Làm 3 việc này 1.000 lần (nhân từ số đo) | khoảng $11,4 | khoảng $6,9 (từ 1/12/2026: khoảng $13,7) |
Vì sao model đắt hơn lại tốn ít tiền hơn?
Tiền tính theo token, và token suy nghĩ tính giá như token đầu ra. Trong lần thử này, Flash dùng 490, 1.322 và 1.100 token đầu ra cho ba đề; Argon dùng 147, 234 và 174. Câu trả lời thấy được dài gần bằng nhau (đề 1 là hai JSON giống hệt), nên phần chênh nằm ở phần suy nghĩ: Flash nghĩ nhiều hơn hẳn trước khi trả lời. Giá mỗi token của Argon cao gấp 2,7 lần, nhưng Argon dùng ít hơn khoảng 5 lần số token đầu ra, nên tổng tiền thấp hơn.
Điều này có thể đổi khi giá đổi: từ 1/12/2026 giá Argon tăng gấp đôi, lúc đó cùng số token này Argon sẽ tốn khoảng $0,0137, nhỉnh hơn Flash. Từ 1/1/2027 giá Flash cũng tăng gấp đôi.
Đoạn code so sánh
Phần gọi Gemini API và tính tiền của script dùng trong bài (Python, thư viện httpx). Token đầu ra lấy cả candidatesTokenCount lẫn thoughtsTokenCount vì bảng giá tính cả hai. Phần chấm giống So kè AI #1: đọc JSON và so từng trường (đề 1), lấy số cuối mỗi dòng của bảng (đề 2), đếm chữ và tìm "10%", hotline, ngày tháng (đề 3).
import time, httpx

PRICES = {"gemini-3.8-flash": (0.75, 3.75), "gemini-4-argon": (2.00, 10.00)}  # USD / triệu token

def ask(model: str, prompt: str, api_key: str):
    started = time.monotonic()
    reply = httpx.post(
        f"https://generativelanguage.googleapis.com/v1beta/models/{model}:generateContent",
        headers={"x-goog-api-key": api_key},
        json={"contents": [{"role": "user", "parts": [{"text": prompt}]}]},
        timeout=600,
    ).json()
    parts = reply["candidates"][0]["content"]["parts"]
    text = "".join(p.get("text", "") for p in parts if not p.get("thought"))
    used = reply["usageMetadata"]
    tokens_out = used.get("candidatesTokenCount", 0) + used.get("thoughtsTokenCount", 0)
    price_in, price_out = PRICES[model]
    cost = used["promptTokenCount"] * price_in / 1e6 + tokens_out * price_out / 1e6
    return text, time.monotonic() - started, cost
Giới hạn của lần thử
- Mỗi đề chạy một lần. Số token suy nghĩ có thể khác nhiều ở lần chạy khác, nên tiền và thời gian cũng vậy.
- Đều là việc ngắn, có đáp án rõ. Chưa thử việc dài, nhiều bước, viết code hay đọc tài liệu lớn, là chỗ Google nói Argon mạnh.
- Giá đang là giá giới thiệu và sẽ đổi: Argon gấp đôi từ 1/12/2026, Flash gấp đôi từ 1/1/2027.
Rút ra: đừng chọn model theo giá mỗi token
- Đo tiền thật trên chính việc của bạn. Giá mỗi token chỉ là một nửa câu chuyện; model nghĩ ít hơn có thể rẻ hơn dù giá cao hơn.
- Yêu cầu có giới hạn chặt (số chữ, định dạng, vị trí dòng cuối) thì viết vài dòng code kiểm. Argon vượt 120 chữ là lỗi mắt rất dễ bỏ qua.
- So lại khi giá đổi. Với API, đổi model chỉ là đổi một dòng
model, nên chạy lại bộ đề của mình mỗi lần bảng giá thay đổi.
Câu hỏi thường gặp
Gemini 4 Argon giá bao nhiêu trên API?
Theo bảng giá Gemini API cập nhật 13/10/2026 (gói trả phí): $2 cho mỗi triệu token đầu vào và $10 cho mỗi triệu token đầu ra (tính cả token suy nghĩ), là giá giới thiệu tới 30/11/2026. Từ 1/12/2026 là $4 và $20. Argon không có ở gói miễn phí.
Gemini 4 Argon có tốt hơn Gemini 3.8 Flash không?
Trong ba việc văn phòng ngắn của bài này: Flash đúng 15/15 mục, Argon 14/15 (email vượt giới hạn 120 chữ). Argon nhanh hơn và rẻ hơn trong lần thử này. Bài chưa thử việc dài, nhiều bước hay viết code.
Vì sao Argon đắt hơn mà tốn ít tiền hơn Flash?
Vì token suy nghĩ tính tiền như token đầu ra. Trong lần thử này Flash dùng 2.912 token đầu ra cho ba đề, Argon chỉ 555, nên dù giá mỗi token của Argon cao gấp 2,7 lần, tổng tiền vẫn thấp hơn ($0,00687 so với $0,01135).
Muốn tự so hai model thì làm thế nào?
Viết sẵn vài đề có đáp án, gửi cùng câu lệnh cho từng model qua API, rồi để code so câu trả lời với đáp án. Lấy số token từ phần usageMetadata API trả về, nhớ cộng cả token suy nghĩ, rồi tính tiền theo bảng giá.
Nguồn tham khảo
- Gemini API — Pricing
Trang của hãng
- Gemini API — Models
Tài liệu của hãng
- Google Gemini Blog: Gemini 4 Argon: our next era of frontier intelligence
Trang của hãng